

HBM5 时代,内存行业和 PCB 都要跟着变
发布时间:2026-09-08 08:52:40


AI大模型越做越大,GPU算力一路往上走,内存却有点跟不上了。千亿乃至万亿参数的大模型训练推理,数据搬运的瓶颈往往先卡在内存一侧,业内把这称为“内存墙”——算力芯片再强,数据喂不进去,性能也白搭。
高带宽内存(HBM)就是为这种场景诞生的。从HBM3、HBM4到HBM4E,带宽天花板被一代代抬高;到了第八代HBM5,制程、架构、散热、封装一起换代,内存行业这一轮的变革,比参数表上那几个数字大得多。
HBM5到底改了些什么
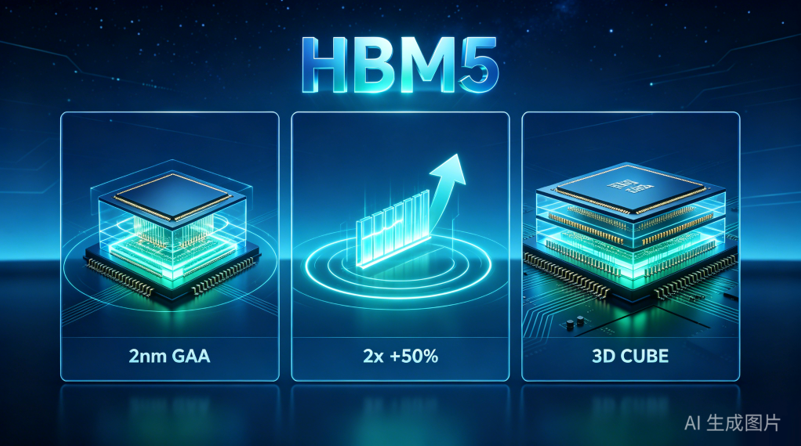
最先变的是底层。HBM5把基础裸片(Base Die)的制程从HBM4E的4纳米推进到三星自研的2纳米GAA(全环绕栅极)工艺,这也是2纳米制程第一次下放到HBM基础芯片制造。相比前代的FinFET,GAA对晶体管的控制更精细,漏电和功耗更可控,这为后面的性能翻倍打了底。
参数上,据三星官方公布的数据,HBM5的综合性能达到HBM4E的2倍,运行速度提升50%以上,每瓦性能提升20%。高端内存过去“高性能等于高功耗”的老毛病,这次算是动了一刀。
带宽上去了,发热也跟着上去了。HBM5在散热上做了一堆功课:沿用HBM4E验证过的热路径块技术疏导核心热源,SK海力士的iHBM智能控温、三星的HPB热管理也都用上了,尽量不让芯片因为局部过热而降频。
架构层面,HBM5搭载全新的CUBE立体集成方案,抛弃传统的平面扩容思路,转向3D垂直集成架构。TSV硅通孔互连和堆叠精度进一步优化,单颗容量与带宽上限继续上探;再配合SiP系统级封装,内存和算力芯片在系统层面的协同,比前代要紧得多。
内存行业这一轮的变局
先说技术逻辑。以前内存迭代,就是带宽、容量这些参数小幅往上挪,制程升级慢吞吞,内存始终是算力的“配角”。HBM5把迭代逻辑整个换了:参数升级退到次要位置,系统级架构革新成了主线,底层2纳米制程下放、GAA新架构、3D堆叠,这些才是竞争的核心。
产业格局也在收拢。HBM5的门槛包括先进制程、精密封装、热管理、架构设计,能玩得转的玩家就剩那么几家——三星和SK海力士靠着先发优势和量产经验,基本锁定了这条赛道的头部位置,中小存储厂商想挤进来,门槛比HBM4时代高了一大截。产业链也随之重构:上游的2纳米晶圆制造、特种TSV封装材料,中游的封装测试、热管理方案,下游的AI算力硬件、超算设备,一条新的高端内存产业链正在成形。
落到应用上,受益最直接的还是AI。万亿参数大模型的训练和推理,最怕的就是GPU等数据,HBM5把内存带宽顶上去,算力利用率能明显抬高。超算、气象模拟、生物医药仿真、航空航天算力推演这类场景,吃的是低延迟、高稳定、高能效,HBM5正好对口;高端服务器和数据中心还能借着它降低整体能耗,省下散热设备的投入。
更深一层的变化在定位。以前内存就是个临时存数据的地方,是算力体系里的辅助件;HBM5把内存和算力芯片在架构上焊在了一起,数据调度、快速交互的能力上来了,内存开始从“存储工具”往“算力核心协同单元”走。研发逻辑也在跟着变,从“先算力、后内存”,转向算力和内存放在一起设计。
落地没那么快:三道坎
变革归变革,落地还得过三关。第一关是量产。2纳米GAA制程、超高堆叠封装、智能热管理叠在一起,工艺复杂度比前代高出一大截,对晶圆制造和封装设备的精度要求极高,而核心设备和工艺高度集中在头部几家手里,良率爬坡需要时间,短期内很难大规模放量。
第二关是成本。先进制程、精密封装、特种散热材料,每一样都在拉高单颗成本,HBM5的单价明显高于HBM4E和传统内存,初期只能用在顶级AI算力和超算上,很难快速下沉到消费电子和中端服务器市场。
第三关是生态。HBM5的架构和性能标准,需要GPU、算力芯片、服务器主板、系统软件、算法调度全面适配。下游软硬件生态还没完全跟上,产业链上下游得一起迭代,这个适配周期短不了。
往后几年会怎么走
方向其实已经比较清楚了。2028年规模化量产落地后,HBM5会逐步取代HBM4、HBM4E,覆盖高端AI算力、超算和大型数据中心,成为下一代高端算力硬件的标配。后续迭代会沿着HBM5的技术路线继续深化——3D集成、智能温控、制程升级,参数竞争弱化,系统级协同和能效优化成为主战场。产业链自主化、本土化的步伐也会加快,高端HBM长期被海外巨头垄断的局面,会随着各国在制程、封装、设备环节的布局而松动。算力和内存的协同设计,将成为下一代硬件研发的默认选项,内存墙这道老问题,有望被从根上拆掉。
说回PCB:HBM5时代,板子也在变
内存带宽上来了,算力芯片吃得饱了,压力就传导到承载它们的板子上。HBM5的高带宽、高功耗特性,意味着AI服务器主板的电源设计、高速走线、层叠架构都得跟着升级——电源层要扛得住更大的电流,内存与GPU之间的高速通道要做严格的阻抗控制,高多层、HDI、背钻这些工艺一个都省不掉。再好的内存颗粒,落在信号完整性不过关的板子上,性能也发挥不出来。
这也是我们一直在做的功课。一博科技提供高速PCB设计、制板到PCBA生产的一站式服务,珠海板厂占地4.5万平方米,专注高多层、高速及高阶HDI制造,重点布局AI算力与服务器领域,已具备132层PCB、10阶HDI、20层Anylayer及光模块PCBA的批量生产能力。七次高精度压合、严格的阻抗控制(±5%)这些工艺细节,就是为HBM5这类高性能算力硬件准备的。HBM5解决的是内存怎么更快,我们解决的是信号怎么在板上稳稳地跑起来。
特别声明:本文部分内容由AI生成,仅为行业技术参考,不构成专业商用指导与投资依据。

