

内存控制器搬进 HBM 堆栈,英伟达 NVHBM 在打什么算盘?
发布时间:2026-09-16 17:28:33


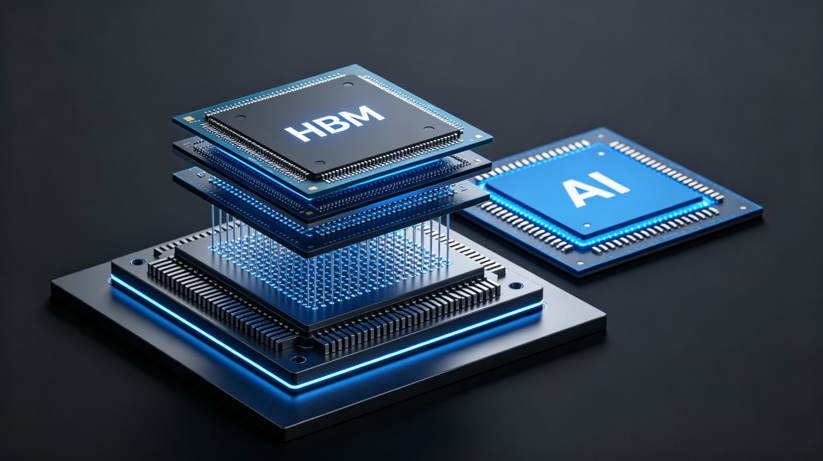
8月,英伟达发布了一项名为 NVHBM 的定制高带宽内存技术,归入 NVLink Fusion 技术体系。与传统 HBM 相比,它最本质的变化是把内存控制器从 XPU 计算芯片一侧,整体迁进了 HBM 堆栈底部的基座裸片(Base Die)里。内存带宽不够用、算力芯片面积不够摆,这两件让 AI 硬件头疼多年的事,英伟达想用这一招一起解。
控制器搬家,HBM 从“听指挥”变成“自己指挥”
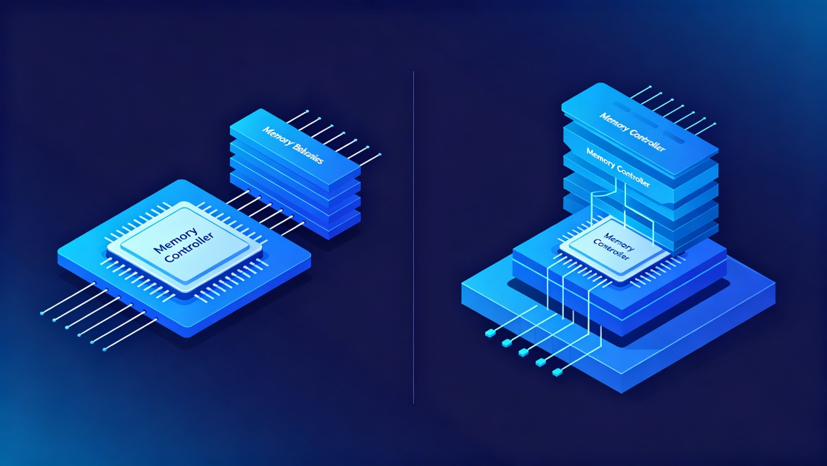
在标准 HBM 的架构里,内存控制器和物理接口 PHY 都长在 XPU 计算芯片上,HBM 堆栈里的 Base Die 只干一件事——物理层的信号转换,两边靠一条又宽又并行的总线连接。这套方案成熟、通用,代价是控制器离存储颗粒远,信号路径长,时序控制也费劲;PHY 电路还占着计算芯片上宝贵的面积。
NVHBM 把英伟达自研的内存控制器和 PHY 电路一并下沉到 Base Die 里,原本只管物理层转换的基座,升级成带完整控制逻辑的“智能内存基座”,连接方式也从宽并行总线换成了窄带串行 Die-to-Die 链路。用大白话说,以前是芯片在外面遥控指挥内存,现在是内存堆栈自己带着指挥系统上班。
存储介质本身没什么花样:依然是 DRAM 颗粒,靠 TSV 硅通孔做 3D 垂直堆叠,属于断电数据不保留的易失性内存,底层堆叠工艺和标准 HBM 兼容,颗粒仍由三星、SK 海力士这类主流存储厂商供货。
算一笔账:带宽、功耗、面积都省在哪儿
拿 NVHBM 和标准 HBM4E 对比,提升是能算出来的。
带宽上,控制器贴近存储层,信号路径明显缩短,时序控制更精细,单栈内存带宽最高能提升 30%,理论单栈带宽到 5.2TB/s。
功耗上,短距通信减少传输损耗,集成度提升压掉接口冗余功耗,HBM 整体功耗最高降 15%,顺带给计算芯片腾出更多散热余量。
面积上是省得最明显的。XPU 上的 PHY 和配套电路面积最高缩减 67%,最多能释放 25% 的计算裸片面积给算力单元;中介层布线也简单了,整体封装布局最多释放 80% 的可用硅片空间,多组 HBM 堆叠的高密度集成更好摆。
系统层面再叠上 NVLink Fusion 体系,单 XPU 端到端整体性能提升 30%。放到数据中心,同等 1 吉瓦功耗预算下,能额外部署约 15000 颗 2000W 级的 XPU——机架级算力密度就是这么拉上去的。
谁先上车?亚马逊打头
生态上,NVHBM 是英伟达主导的定制化方案,眼下正在推动标准化实现规范,联合三星、SK 海力士等头部内存厂商做产品验证;同时作为 NVLink Fusion 半定制 AI 基建的核心组件,向超大规模云厂商和 AI 原生企业开放适配。
目前公开的第一个合作方是亚马逊旗下 Annapurna Labs,其下一代 Trainium4 芯片将接入 NVHBM 生态;AWS 还计划 2027 到 2028 年在全球基础设施里额外部署 200 万颗英伟达 GPU,覆盖 Blackwell Ultra、Rubin 及 Rubin Ultra 架构,同步验证 NVHBM 的落地。
要泼一盆冷水的是,NVHBM 并不是通用标准 HBM 的替代品,而是面向定制化算力场景的补充方案。已量产的 Vera Rubin 机架级系统并不搭载该技术,它瞄准的是下一代定制芯片设计。
前景和变量,都在哪儿
机会是明摆着的。万亿参数模型、长上下文 Agent 这些业务起来之后,内存带宽和算力密度成了 AI 基础设施最硬的瓶颈。NVHBM 用架构重构同时换来带宽升级、功耗下降和面积释放,正好卡在下一代 AI 算力的需求点上,高端训练集群、超大规模推理场景里落地价值明确。再加上数据中心功耗约束越来越严,功耗和密度优势对云厂商意味着更低的运营成本、更高的单位算力产出。
变量也不少。一是定制化属性强,只适配英伟达算力生态,没有 JEDEC 标准 HBM 的跨平台通用性,覆盖场景天然受限;二是架构重构对先进封装良率、TSV 工艺精度、Base Die 设计复杂度都提出更高要求,大规模量产的时间节点、成本控制仍悬着;三是通用 HBM 持续迭代、CXL 内存扩展等技术路线也在同步演进,会在不同场景分流需求。
产业链上,谁在跟着受益?
NVHBM 把控制器搬进 HBM,短期看是英伟达和存储厂商的事,往长了看,整个硬件链条都会被牵动。控制器下沉、信号链路重构,意味着中介层、载板乃至整机 PCB 的设计要求和复杂度都要上一个台阶——高速信号完整性、高密度互连、层数和材料等级,每一项都在考验板厂的功底。
这正是国内 PCB 厂商眼下最忙的业务方向。以深圳一博科技(301366)为例,这家 2003 年成立的公司靠高速 PCB 设计起家,如今拥有 900 余名设计工程师,把 PCB 设计、制板、SMT 贴片到元器件选型串成一站式服务,设计能力覆盖 112G/224G、DDR4/5、PCIe4.0/5.0/6.0 等高速场景,制板能做到 2 层到 132 层。今年以来 AI 算力需求爆发,高端 PCB 一度供不应求,公司部分工序已经满产,ATE 测试板等高阶产品占比也在往上走,数据中心服务器的相关业务被明确列为重点方向。对这类厂商来说,NVHBM 代表的“更高带宽、更低功耗、更高集成度”的演进方向,落到交付端就是一张张更高速、更高层、更难做的板子——谁先接得住,谁就多分一杯羹。
短期看,NVHBM 会率先落到头部云厂商的高端 AI 训练与推理集群里,成为英伟达下一代旗舰算力平台的标配内存方案。长期看,内存控制器向存储端下沉的设计思路,代表了高带宽内存“计算-存储协同设计”的演进方向;但它不会取代通用标准 HBM,两者分别面向定制化高端算力与通用算力场景,互补共存。对产业链上的玩家来说,这场技术变局真正的信号是:算力之争,正从芯片本身延伸到内存、封装和每一块承载它们的电路板上。

